

AIエージェントに車載ECUソフトウェアの回帰検証を任せる—「自己採点」させないための設計—
AIコーディングツールの進化により、実装からテストコードの生成までをAIに任せる場面が増えています。しかし、実装したAI自身に「これで合格です」と言わせてよいのでしょうか。特に、安全性が問われる車載ECUソフトウェアでは、この「自己採点」の危うさを放置できません。このコラムでは、GSILを使い、「複数のAIエージェントの役割を厳密に分離し」「最後の合否判断をAIの主観に任せずコードで機械的に行い」「判断できない場合のみ人に差し戻す」、回帰検証の仕組みをご紹介します。
本コラムで紹介するGSILエージェントループの仕組みは、SAKAKI CONSULTING 榊原 恵氏の開発によるものです。
1. GSILとは
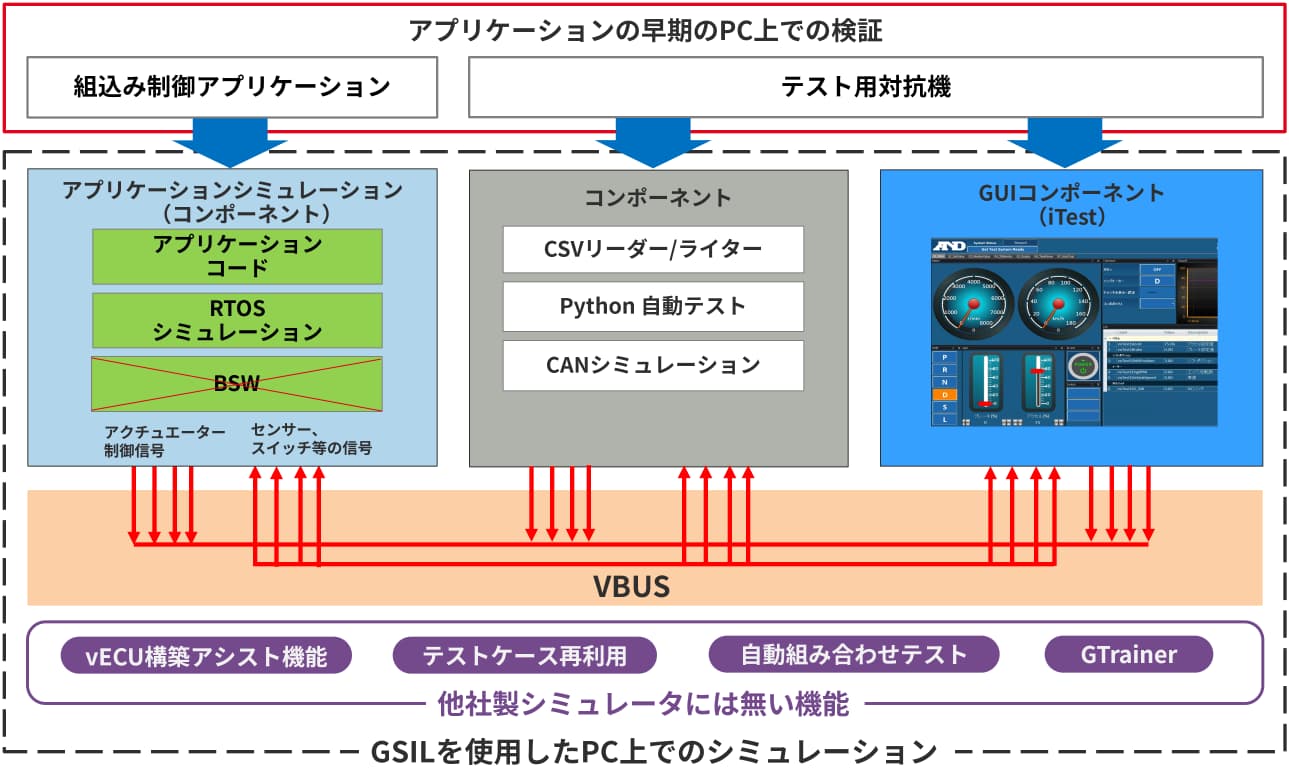
GSILは、車載ECUソフトウェア開発向けのシミュレーションツール(SILS: Software In the Loop Simulation)です。ハードウェアが完成する前の段階からPC上でECUソフトウェアの動作・検証ができる仮想環境を提供し、HILSでのデバッグ作業をほとんど不要にします。
近年、AIコーディングツールの進化により、GSIL上で動く実装コードそのものをAIエージェントに書かせる、という使い方も現実的になってきました。本コラムのテーマは、その一歩先を考える、「検証(テスト)側もAIに任せてよいのか」という問いです。
2. なぜ「AIに検証させる」ことが不安なのか
AIに実装とテストの両方を任せた場合、一般的には次のような手順になります。
AIが要求仕様を読み、コードを書き、そのコード向けのテストケースと期待値を書く。それを実行し、AI自身がその結果を見て「合格です」と報告する。
この手順の弱点は、テストケースと期待値を、実装したAI自身が作るため、無意識のうちに「自分が書いた実装が通る条件」に期待値を寄せてしまう可能性を排除できない点にあります。要求仕様との整合性ではなく、実装との整合性を検証してしまう、という本末転倒が起こり得ます。人間のレビューでも同種の問題(実装者自身によるセルフレビューの限界)は知られていますが、AIが高速に大量のテストを生成できるようになった今、この問題はより顕在化しやすくなっています。
3. 自己採点をさせない設計 ― 役割の分離
そこで、検証の工程を1つのAIに任せきりにするのではなく、以下の4つの役割に分割しました。
- 期待値生成:要求仕様のみを根拠に、期待される動作をチェックリスト化する。実装コードは見ない。
- 裁定:そのチェックリストが要求仕様に忠実かどうかを審査する。実装にも、実行結果にも触れない。
- 実装:要求仕様に基づいて設計・実装を行う。期待値の正解は自分で決めない。
- 実行・判定:承認されたチェックリストをもとにGSILを実行し、結果を機械的に判定する。
この4つを、要求仕様→期待値生成→裁定→実装→実行・判定、という順番で回します。先にチェックリストを固めてから実装することで、「実装を見てから都合よくテストを書く」という抜け道を防ぎます。
それぞれ別のAIエージェント・別のセッションとして実行し、各役割が参照できる情報(コンテキスト)とツールを、ツール権限とセッション分離によって構造的に制限します。「実装は見ないでください」と指示文で頼むのではなく、実装を読む手段そのものをそのセッションに与えない、という構造で担保する点が要点です。
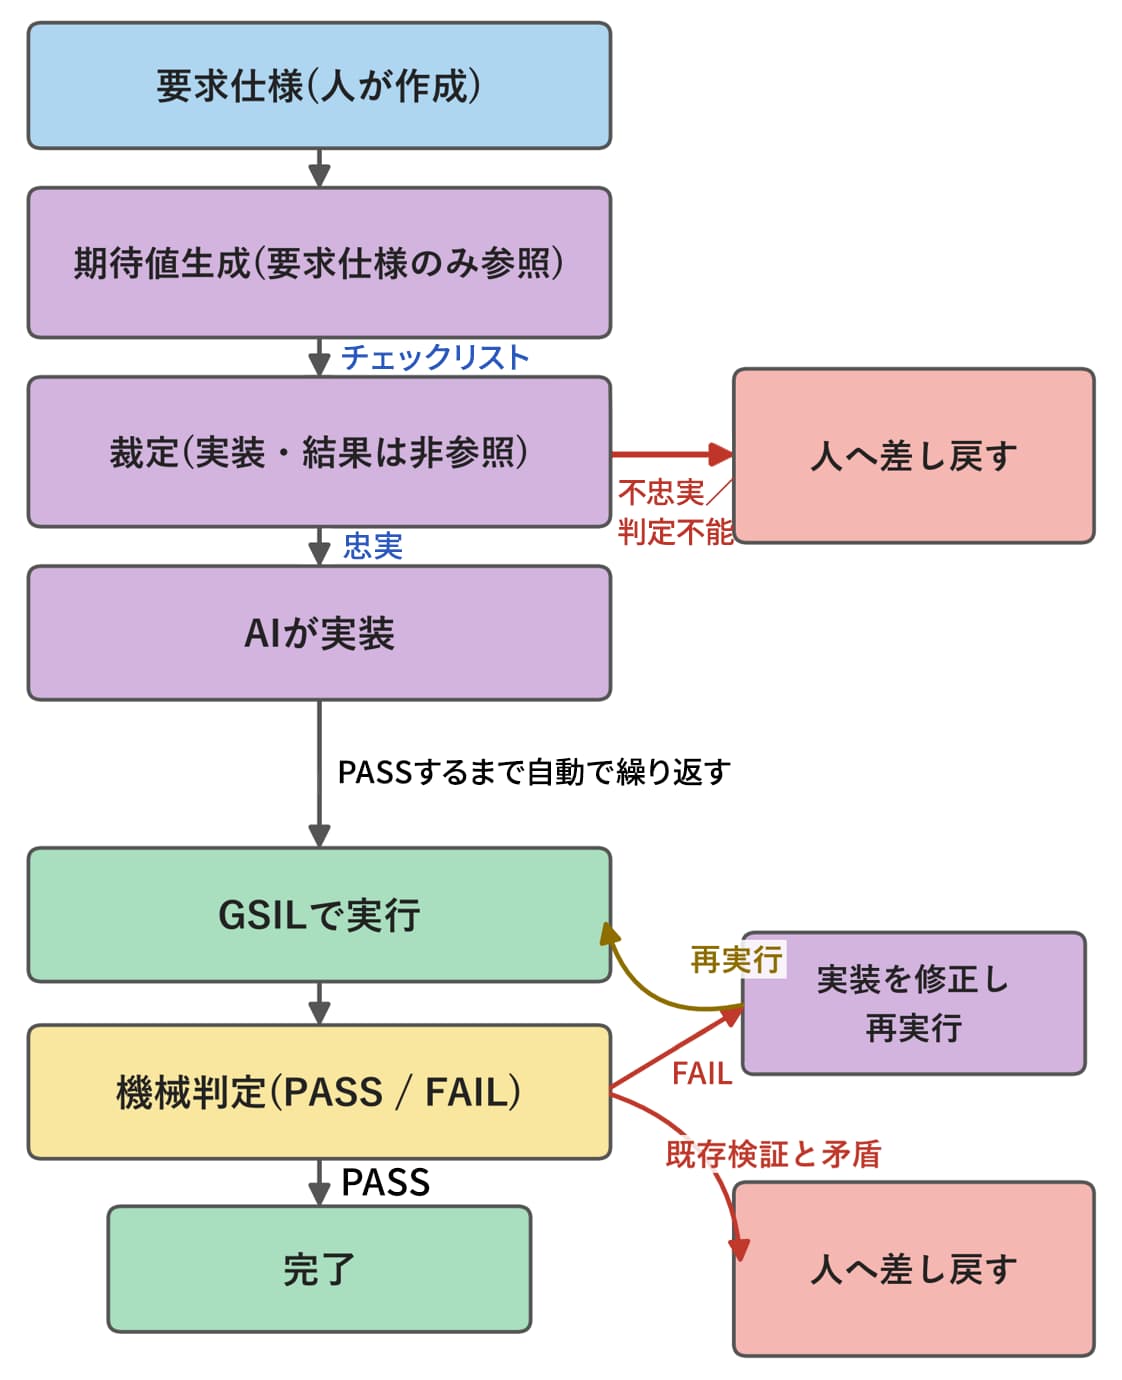
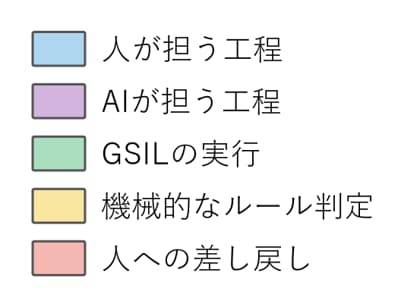
図1:役割分離と検証ループの全体像
4. MCPサーバーとskill ― 役割分離を支える仕組み
前節で述べた「役割ごとに参照できる情報とツールを構造的に制限する」を、実際に成り立たせているのが、MCPサーバーとskillという2つの仕組みです。
MCPサーバー:なぜ必要か
AIエージェントが文章を生成するだけでなく、実際にGSILをビルドしたり実行したりするには、外部のツールを呼び出す手段が別途必要です。MCP(Model Context Protocol)は、この「アクションをAIが呼べる形にする」ための共通規格です。さらに重要なのは、この仕組みにより、「どの役割にどのツールを見せるか」を、プログラムの起動時点で固定できるという点です。「実装は見ないでください」と指示文で頼むのではなく、その役割のセッションには、実装を読むツール自体が存在しない、という構造で担保できます。
MCPサーバー:どう使われているか
今回は、GSIL向けに11個のツールを用意しています。ポイントは、同じプログラムを、起動オプションだけ変えて2つの役割向けに登録している点です。実装(生成者)役のセッションには環境確認・信号一覧の2ツールしか見えず、ビルド・実行・判定系の9ツールは実行・判定役のセッションにしか見えません。
skill:なぜ必要か
ツールを制限するうえで、その役割としてどう判断すべきか、という基準は別に必要です。skillは、この判断基準をあらかじめ文章として書いておく仕組みです。各役割のセッションが始まると、対応するskillの内容が自動的に読み込まれます。これにより、毎回人が口頭で説明し直す必要がなくなるため、説明の抜けや言い忘れも起きません。
skill:どう使われているか
期待値生成・裁定・実行・基準値登録のそれぞれに専用のskillがあり、中身は抽象的な心構えではなく、実際に運用中に起きた失敗(仕様書の文言を誤って引用した事例など)をそのつど教訓化して書き加えたものです。
つまり、ツールが「実際に手を動かす部分」、skillが「AIが判断する時の拠り所」という住み分けであり、この2つを組み合わせることで、「役割を分ける」という設計思想が、口約束ではなく仕組みとして成立しています。
5. 盲検(ブラインドレビュー)裁定 ― 期待値を作る人と、審査する人を分ける
期待値生成と裁定を分けるのは、実装の都合に合わせてテスト条件が変質するのを防ぐためです。期待値生成役は、要求仕様から「何を確認すべきか」を、Test IR(中間表現)と呼ぶ構造化データとして書き出します。これは、自然言語の要求を直接実行スクリプトへ変換せず、一度レビュー可能な形に固定するもので、コンパイラがソースコードを一旦中間表現に変換し、それを機械語に落とすのと同じ発想です。
裁定役は、このTest IRが要求仕様と整合しているかのみを、実装にも実行結果にも触れずに審査し、「忠実」「不忠実」「判定不能」の3段階で判定します。忠実と判定されたTest IRは、以後の編集を行わない前提(凍結)で、実行可能なテストスクリプトへ機械的に変換されます。
このルール群は、抽象的な理想論ではなく、実際に検証を運用する中で起きた具体的な失敗(例えば、仕様書の文言を一字一句正確に引用せず、意味が変わってしまった事例)をそのつど教訓化して積み上げたものです。
6. 最終判断はコードに任せる ― verdict.pyによる機械判定
実行結果からPASS/FAILを決める最終判定も、AIの主観に委ねません。「マーカーによる完走確認」「期待値との照合」「起動時のコンポーネント構成確認」「例外(traceback)の有無」「コンポーネントエラーの検出」「実行時間(wall-clock)の監視」という6つの独立した信号をもとに、優先順位付きのif/elifロジックで、TIMEOUT・ENV_ERROR・COMPONENT_ERROR・EXCEPTION・INCOMPLETE・FAIL・PASSの7種類のいずれかへ機械的に分類します。
同じ入力であれば、誰が何度実行しても同じ結果になります。これは、AIに「たぶん合っていると思います」と判断させないための、意図的な設計です。
7. それでも判断できない時 ― 人へのエスカレーション
この仕組みは、AIに何でも自動で解決させることを目的にしていません。むしろ、判断根拠が不十分な場合には止まることを、設計段階からあらかじめ組み込んでいます。
- 裁定が「不忠実」または「判定不能」になった場合
- 要求仕様同士が矛盾し、期待値を一意に決められない場合
- 既存の検証結果と、新しい実行結果が矛盾し、どちらを正とするか判断が必要な場合
こうした場面では、AIが自動で丸め込んで前に進めるのではなく、矛盾や不確実性をそのまま可視化した状態で、人に判断を差し戻します。
8. 実例: オートクルーズ制御のテストで見えた「仕様の矛盾」
GSIL教材(GTrainer)のクルーズコントロール制御を対象に検証した際に、次のような事例が発生しました。
対象の要求は「車速が目標車速との差20km/h以上に達したらクルーズ制御をキャンセルする」というものですが、争点となったのは、これがオートクルーズ(ACC: 定速走行保持)およびCoast(惰性走行保持)の状態にも適用されるのかという点でした。
車速を上げてACC状態に入れたまま、さらに加速して目標車速との差を20km/h以上に広げ、クルーズが実際にキャンセルされるかを確認するテストを行ったところ、期待値生成・裁定の両AIは独立に「適用される」と判断しました。ところがこの解釈で実装すると、既存のシステムテストの一部と正面から矛盾することになったのですが、これは、ACC・Coast保持中は、意図的に目標車速から20km/h以上乖離させる設計になっていたためでした。
このケースでは、少なくとも記載された要求だけからは適用範囲を一意に解釈できず、既存のシステムテストとの整合について人の判断が必要な状態になりました。AIはどちらか一方を都合よく正解として扱うことなく、矛盾をそのまま残して人に判断を委ね、最終的に「この要求は定速走行時のみに適用する」という決定が人の手でなされました。
9. 実際の生成物サンプル
ここまで説明してきた「チェックリスト」「判定ロジック」「判定結果」が実際にはどのような形のデータなのか、同じ1件のテストケース(IT-023: クルーズモードへの進入を確認するケース)を例に、実際のフォーマットに基づいて通して示します。
■ 要求仕様(引用元)
「車速40km/h以上でCruise Onスイッチが押された時にその時の車速を目標車速にしてクルーズモードにする」
■ 期待値生成役が作るチェックリスト(Test IR)の一部
つまり、人が読む要求仕様をいったん機械処理可能なTest IRに固定し、その後は承認済みのTest IRを基準として実行・判定する、という流れです。
{
  "case_id": "IT-023",
  "req_id": "REQ-001",
  "steps": [
    {"type": "SET", "signal": "AccelPedal", "value": 0.45},
    {"type": "WAIT_TIME", "value": 1.2},
    {"type": "SET", "signal": "ac_on_sw", "value": 1}
  ],
  "evals": [
    {"op": "eq", "signal": "acc_state", "expected": 1},
    {"op": "eq", "signal": "target_speed", "expected": 45.0}
  ]
}
■ 実装コードの一部(verdict.pyの判定ロジック。IT-023の実行結果もこのロジックで判定される)
elif not region.run_found:
    outcome = "INCOMPLETE"
elif eval_summary["fail"] > 0:
    outcome = "FAIL"
else:
    outcome = "PASS"
■ 判定結果(verdict出力、IT-023の場合)の一部
{
  "case_id": "IT-023",
  "outcome": "PASS",
  "eval_summary": {"total": 2, "success": 2, "fail": 0}
}
以上は、すべてIT-023という同じケースについての例であり、実際のスキーマ(フィールド名・コードの構造)に基づいています。信号名(AccelPedalやac_on_swなど)も実際に使われているものです。
10. 実際のプロジェクトへの応用
先のIT-023はGTrainerを対象にした例ですが、実際のプロジェクトへの適用時は、生成物を4つの層に分けて捉えると、何を作り直し、何を再利用できるかが整理しやすくなります。
| 層 | 内容 | 再利用性 |
|---|---|---|
| 層 1: GSIL ツール一般 | MCP サーバー、ビルド・実行・判定ツールの仕組み | 高い。GSIL を使う案件で共通資産として使い回せる |
| 層 2: 対象ハーネス固有 | プロジェクトパス、silconf/vecuconf、信号定義、基底クラスなど | 対象ごとに設定が必要 |
| 層 3: 要求内容依存 | 要求仕様(人が用意)、テストケース・期待値(要求仕様から AI が生成) | 案件ごとの要求仕様に応じて都度生成が必要(手作業ではなく AI が生成) |
| 層 4: 方法論一般 | 盲検裁定、自己採点防止、エスカレーション、機械判定 | 高い。GSIL 以外の検証にも応用可能 |
実コードでは、層2にあたる対象固有の情報の多くを SRC/06_env_config/gsil_target.json という設定ファイルに集約しており、MCPサーバー本体(server.py)は対象固有の情報を直接は持ちません。新しい対象へ展開する際は、基本的にこの設定ファイルと、層3にあたる対象固有の要求仕様を用意すれば、テストケース・期待値はそこからAIが生成し、層1・層4の仕組みと方法論はそのまま再利用できます。
このように生成物を層として切り分けておくことで、対象が変わっても作り直す範囲を層2・層3に限定でき、展開のたびにゼロから作り直す事態を防ぐことができます。
11. まとめ — AIを信用するのではなく、構造で守る
AIエージェントに回帰検証を任せる上で重要なのは、「このAIは信頼できるか」を問うことではなく、「どのAIに何を見せるか」「どこから先は人ではなくコードで機械的に決めるか」を、あらかじめ設計として分離しておくことです。
- 実装工程と期待値を決める工程を分離し、自己採点を防ぐ
- 期待値の作成と審査を別のAIに分離し、盲検で整合性を確認する
- 最終的な合否は、AIの主観ではなく決められたコードが機械的に判定する
- 判断根拠が不十分な場面では、AIが丸め込まず人に差し戻す
GSILは、こうした役割分離・機械判定・人へのエスカレーションを、AIエージェントと組み合わせて実践するための土台として活用できます。実機レス・早期検証に加えて、AI時代の「検証をどう信頼するか」という課題にも、今後取り組んでいきます。
この検証の仕組みの開発
SAKAKI CONSULTING合同会社
榊原 恵(さかきばら けい)
GSILエージェントループ(役割分離・盲検裁定・機械判定による回帰検証の仕組み)の設計・実装・検証を担当。
このコラムの著者
株式会社ユビキタスAI
エンベデッド第3部 担当部長
植田 宏(うえだ ひろし)
大学卒業後Tier1メーカーへ入社、ECUソフトウェア開発を行う。その後海外で組込みソフトウェア開発エンジニアの経験を経て、帰国。1998年より車載系ソフトウェアの技術営業に従事。自身の経験を活かし、課題解決に役立つ海外のソフトウェア商材を取扱い、国内のエンジニアへ届けている。
より詳しく技術や関連製品について知りたい方へ


ECUソフトウェアのカバレッジを90%以上に向上させる方法 ─ GSILの自動網羅テスト─
2026.07.14

マルチコアRTOS設計における実装前検証 ― chronSUITEによるタスクタイミングの可視化 ―
2026.06.23
SDV・マルチコア時代のブレーキ制御ECUに求められるタイミング検証とは
2026.06.09
GSILの網羅的自動テストケース生成機能を使ったECUの信頼性向上
2025.04.14
ソフトウェアアプリケーションの実行速度高速化技術
2024.09.04
組込み制御ソフトウェアでのCIの課題と実現方法
2024.09.02
イベントチェーンを応用した車載ECUのタイミング検証
2024.08.30
車載制御ECUソフトウェア教育向けパッケージGTrainerとは
2024.08.08
システムテストのカバレッジ測定
2024.06.13
組込み制御ソフト開発へのシミュレーション応用による開発効率向上
2024.06.04
CANを使用したSILSテスト ―車両全体シミュレーション、テストケース再利用―
2024.05.27
GSILのMILS開発への適用
2023.12.20
GSILのCI(Continuous Integration)適用
2023.09.22
OEM⇔サプライヤでのECU制御ソフトウェア環境共有による手戻り工数削減方法
2023.07.25
SILSを使用した車載制御ECUソフトウェア開発競争力強化
2023.07.20
車載ECUシミュレーションでテスト資産を活かすための技術とは?
2022.05.16
早期の車載ECUタイミング検証の実現
2021.08.27

